
Kafka 알림 소비자를 SQS 가시성 타임아웃과 RedrivePolicy로 옮기기
앞 글에서는 마냑의 스토리 완성 알림을 Kafka에서 받아 Redis로 중복 발송을 막고 재시도 토픽과 DLQ를 붙였다. 마냑은 사용자가 설정을 넣으면 AI가 스토리를 만들고 그 스토리 속 인물과 채팅하는 서비스다.
이번에는 같은 알림 소비자를 개발서버의 SQS로 옮겼다. Kafka에서는 실패 메시지를 재시도 토픽에 발행했지만 SQS에서는 메시지를 지우지 않으면 다시 받는다. 개발서버에서 실제 스토리를 완성해 보니 자격 조회가 404로 실패했고 메시지가 다섯 번 수신된 뒤 DLQ로 갔다. 설정을 고치고 그 메시지를 다시 옮겨 브라우저 푸시까지 확인했다.
알림 서비스의 환경은 앞 글과 같다. SQS 소비에는 Spring Cloud AWS를 썼다.
| 항목 | 환경 |
|---|---|
| Java | 21 |
| Kotlin | 2.2.21 |
| Spring Boot | 4.0.6 |
| Redis | 7 |
| Spring Cloud AWS | 4.1.1 |
오프셋 대신 삭제로 소비를 끝내기
Kafka에서는 파티션을 한 소비자가 맡고 오프셋을 넘겨 처리를 끝낸다. SQS에는 오프셋이 없다. 받은 메시지도 큐에 남아 있으며 소비자가 삭제해야 사라진다.
받은 메시지는 가시성 타임아웃 동안 다른 소비자에게 보이지 않는다. 그동안 삭제하지 않으면 다시 보인다. 타이머는 소비자가 죽은 시점이 아니라 메시지를 받은 시점부터 돈다. 그래서 SQS의 실패 처리는 메시지를 지우지 않는 것이다.
기존 Kafka 어댑터는 RETRY를 예외로 바꿔 실패 메시지를 .retry 토픽으로 옮겼다. SQS 어댑터에서는 같은 결과를 예외로 바꿔 리스너가 삭제하지 않게 했다. 알림의 자격 확인과 Redis 멱등 처리는 공용 알림 소비자가 그대로 맡는다.
@Component
@Profile("dev | prod")
class SqsNotificationListener(
    private val mapper: ObjectMapper,
    private val consumer: NotificationConsumer,
    @Value("\${manyak.push.queue-url}") queueUrl: String,
) {
    init {
        require(queueUrl.isNotBlank()) { "manyak.push.queue-url must not be blank in dev/prod" }
    }

    @SqsListener(
        queueNames = ["\${manyak.push.queue-url}"],
        acknowledgementMode = "ON_SUCCESS",
        pollTimeoutSeconds = "20",
        maxConcurrentMessages = "2",
        maxMessagesPerPoll = "2",
    )
    fun receive(payload: String) {
        // 파싱·검증 실패도 예외로 전파한다. 삭제하거나 직접 DLQ로 보내지 않고 큐의 Redrive에 맡긴다.
        val message = mapper.readValue(payload, PushMessage::class.java).also { it.validate() }
        // 상관 ID와 outcome 카운터는 Kafka와 같은 소비자가 기록한다.
        if (consumer.onMessage(message) == ConsumeResult.RETRY) throw RetryMessageException()
    }
}ON_SUCCESS라 메서드가 정상 종료하면 삭제하고 예외가 나면 큐에 남긴다. SUCCESS와 DISCARD는 정상 종료하고 RETRY는 예외로 끝난다. 파싱과 검증 실패도 예외로 전파한다.
Kafka에서는 재시도 대상 예외를 RetryMessageException으로 제한했으므로 파싱 실패는 곧장 .dlq로 갔다. SQS에는 곧장 DLQ로 보내는 설정이 없다. 앱에서 DLQ로 직접 발행하면 권한과 코드 경로가 늘고 로그만 남기고 삭제하면 원본을 잃는다. 파싱 실패는 Redis 선점과 FCM 호출 전에 일어나므로 다시 받아도 발송하지 않는다. 예외를 그대로 두고 큐의 재전달 정책에 맡겼다.
재시도 횟수와 DLQ를 큐에 두기
몇 번까지 다시 시도하고 언제 포기할지는 SQS 큐가 정하게 했다. 큐가 메시지 수신 횟수를 세고 최대 수신 횟수를 넘기면 DLQ로 옮긴다. Kafka에서 앱이 맡던 재시도와 DLQ 설정을 Terraform으로 관리하는 큐 설정에 두었다.
locals {
  push_consumer_timing = {
    visibility_timeout_seconds = 60
    max_receive_count          = 5
  }
}
resource "aws_sqs_queue" "push_requested" {
name = "${var.project}-${var.environment}-push-requested"
visibility_timeout_seconds = local.push_consumer_timing.visibility_timeout_seconds
sqs_managed_sse_enabled = true
redrive_policy = jsonencode({
deadLetterTargetArn = aws_sqs_queue.push_requested_dlq.arn
maxReceiveCount = local.push_consumer_timing.max_receive_count
})
tags = {
Name = "${var.project}-${var.environment}-push-requested"
}
}개발서버 큐의 가시성 타임아웃은 60초이고 최대 수신 횟수는 5회다. DLQ는 메시지를 14일 보관한다. 재시도 횟수를 바꾸려면 이제 앱을 배포하는 대신 Terraform을 적용한다.
큐와 앱이 서로 다른 재시도 시간을 전제로 동작하지 않게 해야 했다. 60초와 5회는 Terraform 한 곳에서 정의하고 큐 설정과 알림 컨테이너의 환경 변수에 함께 전달했다. 앞 글에서 만든 선점 2분 < (5 - 1) × 60초 기동 검사가 SQS 설정과 다른 값을 보지 않게 하려는 것이다.
표준 큐를 고르고 20초 롱폴링 설정하기
표준 큐는 드물게 같은 메시지를 두 번 줄 수 있고 순서를 보장하지 않는다. FIFO 큐는 중복 제거와 그룹 내 순서를 제공하지만 처리량 상한이 있고 앞 메시지가 막히면 같은 그룹의 뒤 메시지도 기다린다. 알림에는 순서가 필요 없고 중복 발송은 앞 글의 Redis 멱등 처리로 막고 있어 표준 큐를 골랐다. Kafka 발행 때 쓰던 수신자 ID 메시지 키도 표준 큐에는 없다.
빈 큐를 계속 짧은 간격으로 조회하면 요청만 쌓인다. 20초 롱폴링을 쓰면 SQS가 요청을 최대 20초 기다렸다가 메시지가 오는 즉시 응답한다. 큐 자체의 기본 대기 시간은 0초라 리스너에 따로 설정했다.
서울 리전 SQS 표준 큐는 100만 요청당 USD 0.40이고 월 100만 요청까지 무료다. 빈 큐에서 폴러 하나가 20초씩 기다리면 30일 동안 129,600회 요청으로 무료 구간의 약 13%다. 이 값은 빈 큐를 전제로 한 추정이며 메시지가 오면 대기가 일찍 끝난다.
60초 뒤 처리 중인 메시지를 다시 받는 경우
알림 한 건의 처리 상한 예산은 약 104초라 SQS 가시성 60초보다 길다. 가시성을 120초로 늘리거나 처리 도중 제한 시간을 연장할 수도 있었지만 60초를 유지했다.
먼저 받은 소비자가 아직 처리 중일 때 60초가 지나 다른 소비자가 메시지를 받을 수 있다. Redis의 처리 중 키가 남아 있으면 나중에 받은 소비자는 BUSY로 RETRY를 반환하고 발송하지 않는다. 먼저 받은 소비자의 삭제는 오래된 수신 핸들이어서 성공 응답이 와도 메시지를 지우지 못할 수 있다. 그때 다시 받은 소비자는 Redis의 DONE을 보고 삭제한다.
수신 핸들은 메시지를 받을 때마다 새로 발급되는 삭제용 영수증이다. 이 선택은 중복 발송 대신 수신 횟수를 더 쓸 수 있다. 앞 글에서 Redis 선점을 연장하지 않아 죽은 소비자가 남긴 메시지를 재시도 창 안에서 다시 선점하게 한 원칙과 같다.
서버 발행 어댑터를 SQS로 바꾸기
아웃박스 릴레이는 브로커별 발행 방법을 몰라도 되게 했다. 로컬에서는 Kafka 어댑터가 push.requested로 보내고 개발/운영 서버에서는 SQS 어댑터가 같은 메시지를 보낸다. 서버에 이미 S3용 AWS SDK v2 2.46.7이 있었고 SQS 발행은 한 번의 호출이라 발행 쪽에는 SDK 클라이언트를 직접 썼다. 소비 쪽은 폴링과 동시 처리, 삭제까지 관리해야 하므로 Spring Cloud AWS 리스너에 맡겼다.
class SqsPushPublisher(
    private val sqs: SqsAsyncClient,
    private val mapper: ObjectMapper,
    private val queueUrl: String,
) : PushPublisher {
    override fun publish(message: PushMessage): CompletableFuture<Unit> =
        try {
            val request = SendMessageRequest.builder()
                .queueUrl(queueUrl)
                .messageBody(mapper.writeValueAsString(message))
                .build()
            sqs.sendMessage(request).thenApply { Unit }
        } catch (ex: Exception) {
            CompletableFuture.failedFuture(ex)
        }
}
SQS 자동 구성은 개발/운영 서버 프로파일에서만 켰다. 큐로 바꾸자 서버가 알림 서비스를 직접 호출하지 않아 알림은 들어오는 요청이 없는 서비스가 됐다. 개발서버에서는 알림 컨테이너를 기존 태스크에 붙여 서버 내부 API와 Redis를 localhost로 호출했다. 이 구성에서는 서버와 알림이 태스크 역할을 공유해 서버에도 SQS 수신과 삭제 권한이 생기고 알림 배포 때 태스크 전체가 재시작된다.
첫 스토리 완성에서 404와 다섯 번 재수신
개발서버에 manyak-dev-push-requested와 DLQ를 만들고 알림 컨테이너를 띄웠다. Container io.awspring.cloud.sqs.sqsListenerEndpointContainer#0 started 로그를 확인한 뒤 서버를 MANYAK_PUSH_MODE=remote로 바꿨다.
개발서버 웹에서 간편 제작으로 스토리를 완성하자 알림은 발송 자격 조회에 실패했다. 04:10:04 UTC에 ELIGIBILITY_UNAVAILABLE로 RETRY했고 04:11:03, 04:12:03, 04:13:03에도 같은 세 줄이 반복됐다. 서버에는 내부 자격 조회 GET /internal/users/4821ef9f-.../push-eligibility가 404로 끝난 기록이 남았다. 60초 간격의 재수신이 로그에 드러났다.
자격 조회 서비스는 사용자가 없어도 200과 USER_NOT_FOUND를 반환한다. 404는 컨트롤러 앞에서 난 것이었다. 내부 API 인증 필터는 공유 시크릿이 비어 있으면 내부 API를 404로 숨기고 값이 틀리면 401을 준다. 헤더 없이 개발서버 공개 주소의 내부 API를 호출해도 404였다.
ECS exec로 서버와 알림 컨테이너의 MANYAK_INTERNAL_SHARED_SECRET 길이를 확인하니 둘 다 0이었다. Secrets Manager에서도 키는 있었지만 값 길이가 0이었다. 시크릿을 넣던 명령은 jq --arg v "$(openssl rand -hex 32)"로 값을 만들고 키 개수가 17에서 18로 늘어난 것만 확인했었다. openssl 결과가 왜 비었는지는 확인하지 못했다.
그 사이 메시지는 다섯 번 수신된 뒤 DLQ로 옮겨졌다. DLQ에서 1건을 확인했다. 실패 메시지를 삭제하지 않고 큐 설정에 재전달을 맡긴 결과였다.
시크릿 복구 뒤 DLQ 한 건 다시 보내기
/dev/urandom으로 64자 시크릿을 만들고 저장 전에 길이 64와 키 개수가 그대로인지 확인해 다시 넣었다. ECS는 태스크가 시작할 때 시크릿을 읽으므로 force-new-deployment로 재시작했다. 이제 헤더 없이 내부 API를 부르면 401이 나왔다.
DLQ의 원본 메시지는 이동 작업으로 다시 보냈다.
aws sqs start-message-move-task --source-arn <DLQ ARN>이동 작업은 COMPLETED로 끝났고 1건을 옮겼다. 04:24:25 UTC에 앞서 실패한 story-completed:02e148a0-482f-4afd-a50c-15bbfcea6d2f가 SUCCESS, OK로 처리됐다. 서버 자격 조회는 200이었고 큐와 DLQ는 모두 0건이 됐다. 앞선 실패에서는 Redis에 완료 기록인 DONE이 남지 않아 같은 메시지 ID도 정상 발송할 수 있었다.
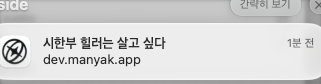
브라우저에도 방금 완성한 스토리 제목의 푸시가 도착했다.
운영 적용 전 점검
이번 확인은 개발서버 태스크에서 한 메시지가 404로 실패해 DLQ로 이동하고 설정 복구 뒤 재처리되는 경로였다. 가시성 60초 안에 처리가 끝나지 않는 경우의 수신 핸들 동작이나 표준 큐의 드문 중복 전달을 따로 실측한 결과는 아니다. 그 경우에는 앞 글의 Redis BUSY와 DONE 처리에 의존한다.
개발서버에서는 서버와 알림이 태스크 역할을 공유하고 배포도 함께 움직인다. 재시도 시간을 바꿀 때는 큐의 가시성과 최대 수신 횟수뿐 아니라 알림의 Redis 선점 유효시간 검사에도 같은 값이 들어가는지 확인해야 한다.
이번 적용은 개발서버 기준이며 운영에서 별도 서비스로 나누는 과정은 다음 글에서 다룬다.
정리
SQS는 받은 메시지를 지우기 전까지 가시성 타임아웃 동안만 숨기고 지우지 않으면 다시 내보낸다. 몇 번 만에 포기할지는 큐의 재전달 정책이 정한다. 개발서버에서 실제로 다섯 번 재수신된 메시지가 DLQ로 갔고 원인을 고쳐 되돌린 뒤 같은 메시지 ID의 푸시가 브라우저에 도착했다.